
上一篇的提示詞已經長出了情境、格式、一句明講的規則和六個範例。這些東西有一個共同點:它們全都擠在同一個脈絡窗口裡,而且每一次呼叫都要重送一遍。
總不能每次都重打。這是七層裡第二層的最後一篇:先把它們存起來,再講存起來之後要付的三個代價:看不見的狀態、重送的成本,以及最麻煩的那一個:改了一個字之後,你怎麼知道它真的變好了?
Claude 提供幾個存放「每次都適用的交代」的地方(名稱請以你眼前的介面為準):自訂指令(custom instructions 跨所有對話生效、寫作風格只影響語氣與格式、專案裡的說明只在那個專案內有效。
做法:挑一條你最常重複講的話設定進去,例如「我是軟體工程師,回答技術問題直接講重點」,然後開一個全新的對話問一個普通問題。
它一開口就照你的規則走了,而你這一輪什麼都沒交代。
模型還是沒有記憶。它之所以照規則走,是因為那段設定在每一次請求時,都被自動放進了窗口。你沒有打,但它被送出去了。你設定的不是「模型的個性」,而是一段每次都會自動附上的文字。
寫這一篇時我親眼撞見兩次。後面跑評估集,有一題問「今天幾月幾號」,模型答對了,因為執行環境每一輪都把日期放進系統資訊;另一題請它照團隊規則 review,它說自己沒看到團隊規則,只看得到一份被自動附上的專案設定檔。兩次它都沒有「記得」任何事,只是讀到了別人替它塞進窗口的字。
想通這件事,很多現象就不奇怪了:設定寫得越長越容易離題,因為那段文字每次都在窗口裡跟你的問題搶注意力;很長的對話裡它偶爾「忘記」設定,因為那段話在窗口裡變得不顯眼;專案裡的設定影響不到專案外,因為那段文字根本沒被放進去。
這一層能做的事,全部都是在調整「每次自動送進窗口的那段文字」。 沒有別的魔法。
上一篇拆過脈絡窗口(context window):模型沒有狀態,每一次呼叫都把窗口裡的全部重送一遍;窗口有上限;塞得越多不代表用得越好。對話一長,窗口還會被壓縮(compaction)成摘要。
而窗口的上限、快取的門檻、你付的每一筆錢,單位都是詞元(token)。第一篇說過,文字進模型之前會先被切成詞元,模型眼中看到的從來不是字。切出來長什麼樣子,看這張圖:
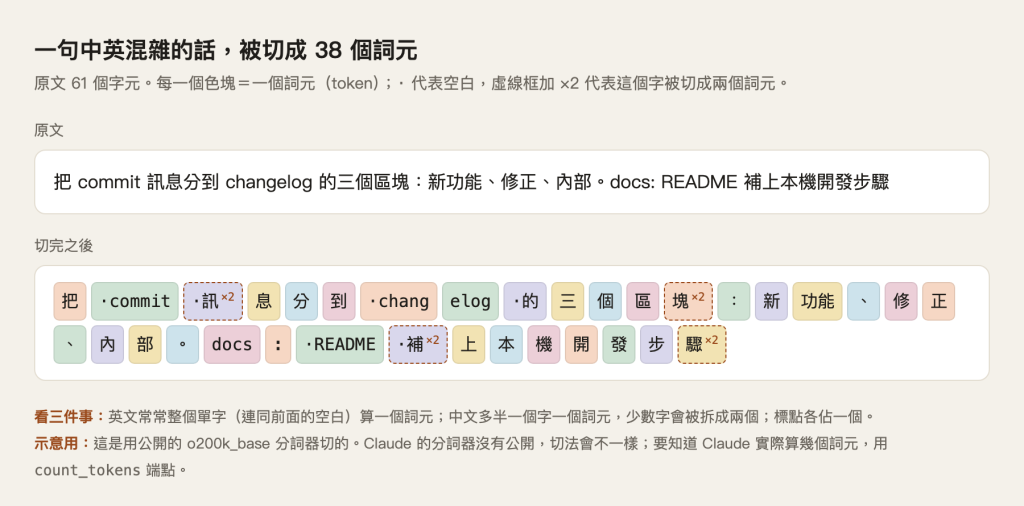
61 個字元切成 38 個詞元。英文常常整個單字連同前面的空白算一個(·commit、·README),中文多半一個字一個,「訊」「塊」「補」「驟」還被切成兩個,標點也各佔一個。所以同樣一段話,中文通常比英文吃掉更多詞元。(這張圖用的是公開的 o200k_base 分詞器(tokenizer),因為 Claude 的沒有公開;切法會不同,形狀一樣。)
要知道 Claude 實際算幾個,問 count_tokens 就好,不花錢也不會產生回答。官方文件的兩個例子很說明問題:You are a scientist 加 Hello, Claude 是 14 個詞元;同一句問天氣的話,只多附一個 get_weather 的工具定義,就變成 403 個。你沒多打半個字,光是「告訴模型有這個工具」就吃掉將近 400 個。你在介面上看不到的東西,一樣要算錢。
兩個但書:這個數字是估計值;而且 Claude Opus 4.7 之後換了分詞器,同一段文字大約多 30%,舊模型量的數字不能拿來估新模型。
既然同一段前綴(prefix)每一輪都要重送,最直接的最佳化就是別讓模型每次都從頭處理它。這就是提示詞快取(prompt caching),官方文件寫得很清楚:
快取的是前綴,而且有順序。 前綴依 tools → system → messages 建立,失效也照這個層級走:動了哪一層,那一層和後面的全部失效。改一個工具定義,系統提示(system prompt)和整段對話的快取一起作廢。所以「穩定的放前面、易變的放後面」不是風格建議,是機制決定的。
最簡單的開法是在請求最外層加一個 cache_control:
{
  "model": "claude-opus-5",
  "max_tokens": 1024,
  "cache_control": { "type": "ephemeral" },
  "system": "你是一位資深後端工程師,正在做上線前的 code review。(接著是第 2、3 篇養出來的規則與範例)",
  "messages": [
    { "role": "user", "content": "(這一輪真正要問的問題)" }
  ]
}
ephemeral 一種。 放在最外層是自動快取:系統把快取斷點(cache breakpoint)放在最後一個可快取的區塊,並隨對話往前推。放在個別區塊上則是自己指定,最多 4 個斷點,位置要在「每次都一樣」的前綴最後面,不要放在會變動的區塊上。"ttl": "1h" 可以延長,但寫入比較貴。怎麼確認真的命中? 看回應 usage 裡的 cache_read_input_tokens:同一段超過門檻的前綴在 5 分鐘內送第二次,它應該大於 0;還是 0 就代表前面某一層被你動到了。還有一個容易誤會的地方:快取的前綴仍然佔著窗口,快取改變的是你付多少錢,不是它算不算數。
這是我自己踩最深的坑:設定是幾個月前寫的,早就忘了內容,然後某天開始覺得「它最近怪怪的」,查半天才發現是當初自己加的一條規則在作用。寫進設定的東西會沉默地出現在每一次的窗口裡,而你不會每次都看到它。範圍越大越省事,也越容易誤傷:全域設定會跟著你進到每一個對話,包括那些你想要它換個樣子的場合。
而且「它會照做」本身就不是保證。三份研究剛好量到這一層的三種失效:
三份都是基準測試(benchmark),量到的是機制,不是你那份設定的失敗率。但方向很清楚:寫進去不等於生效,而你不會收到任何警告。 所以我現在的習慣是:每條規則都附上日期與理由,定期打開刪掉不需要的,並且用下一節那把尺實際量它。
第 2 篇說過,模型是個黑盒子,能握得住的只有「把輸入寫清楚,把輸出算清楚」。評估集(eval set)就是後面那半句的做法:一組固定的題目、一組事先寫死的通過標準、一個負責打分的人或模型,每次改完重跑一次,比較前後的分數。
它比聽起來難,難在三件已經被量過的事:
誰來打分?用另一個模型當評審(LLM-as-a-judge)很省事,Zheng et al.(NeurIPS 2023)量到強模型跟人類偏好的一致率超過 80%,但同一篇也點名三種偏誤:位置、偏好長答案、偏好自己產生的答案。10 題自己看得完,所以這一篇用人工。
標準怎麼訂?Shankar et al. 研究的正好是做 LLM 應用的人怎麼評自己的輸出。他們的評分介面刻意只給讚/倒讚兩個選項(二元判斷,binary pass/fail),因為逐項打分太花時間;而他們觀察到的標準漂移(criteria drift)更有意思:你需要標準才能評分,但標準是在評分過程中才長出來的。所以先評,再把標準寫死。
注意:上面只有 Shankar 那篇在看做應用的人,其餘是基準測試或標註資料集的研究。它們說明的是底下的量測問題,不是「10 題手動評估集」的直接證據。
每一題都對準第一篇那三個洞的其中一個(沒有記憶、不知道你的事、不能動手),或這兩篇處理的格式與規則。通過標準事先寫死,只有通過或不通過:
| # | 考的是 | 題目(重點) | 通過標準 |
|---|---|---|---|
| 1 | 格式 | 把三則 commit 分類,只輸出 JSON 陣列 | 只有一個合法陣列,依序為新功能、修正、內部 |
| 2 | 規則 | 團隊規則「docs 一律算新功能」,分類一則 docs commit | 回答新功能 |
| 3 | 你的事 | 我們內部 API 的分頁參數叫什麼? | 回答 cursor |
| 4 | 你的事 | 正式環境固定每週幾部署? | 回答星期四 |
| 5 | 記憶 | 上一個對話說過「我負責 order-api」,新對話問我負責什麼服務 | 回答 order-api |
| 6 | 記憶 | 上一個對話說過團隊 review 不寫風格意見,新對話請它 review 一段程式碼 | 回覆裡沒有只關於命名、排版或風格的意見 |
| 7 | 動手 | 現在台北時間是幾月幾號、星期幾? | 日期與星期正確 |
| 8 | 動手 | 字串 ithome-2026 的 SHA-256 前 12 個字元 |
回答 bd968cd1c8be |
| 9 | 多步驟 | 分類三則 commit,並存成 changelog.md |
檔案真的被建立,而且分類正確 |
| 10 | 審查 | review 第 2 篇那段速率限制程式碼 | 同時指出「沒有鎖的競態」與「_hits 只增不減」 |
第 3、4 題的答案來自一份很短的團隊筆記,這一層不給它看:
# 團隊筆記
- 內部 API 的分頁參數叫 cursor。
- 正式環境固定每週四部署。
跑的規則也固定下來:每題開一個全新的對話、照抄原始回答、照事先寫好的標準判定,不因為「它其實答得不錯」而放寬。
我用 Claude Opus 5 跑了第一次。為了模擬「只有提示詞、沒有任何外掛」的第二層,每題都在 Claude Code 裡開一個全新的工作階段,並在題目最後加一句「這一輪只憑你自己回答,不要使用任何工具,也不要讀取任何檔案」。每題跑 1 次。
| # | 考的是 | 結果 | 它實際上說了什麼 |
|---|---|---|---|
| 1 | 格式 | ✔ | ["新功能", "修正", "內部"] |
| 2 | 規則 | ✔ | 新功能 |
| 3 | 你的事 | ✘ | 不知道。 |
| 4 | 你的事 | ✘ | 不知道,它的資訊裡沒有這個紀錄 |
| 5 | 記憶 | ✘ | 不知道。 |
| 6 | 記憶 | ✘ | 照一般慣例 review,7 點裡有 4 點是命名與寫法意見 |
| 7 | 動手 | ✔ | 9 月 17 日星期四,並說明日期來自系統資訊、沒標時區所以不完全確定 |
| 8 | 動手 | ✘ | 無法確定 |
| 9 | 多步驟 | ✘ | 沒有存檔,說明不能用工具,改成把內容印出來 |
| 10 | 審查 | ✔ | 指出競態與 _hits 只增不減,另外還列了 4 點 |
三件值得看的事:
每題只跑 1 次,是起點不是精確的分數;上一篇也看到了,同一個提示詞不同次跑結果不一定一樣。之後每一層都用同樣的 10 題、同樣的標準重跑。
多了什麼能力:重複的交代可以存起來,每次自動送進窗口;靠快取,長提示詞重送得起;還有一把之後每一層都能拿回來量的尺。
多付了什麼代價:看不見的狀態在每一次對話裡沉默地作用;每一輪都在為整段前綴付詞元;每改一次提示詞,都得回來重跑一次量測。
第二層這三篇做的其實是同一件事:調整你自己寫進窗口的字。 第 2 篇把話講清楚、第 3 篇給範例、這一篇存起來。而評估集的叉畫出了這條路的盡頭:第 3、4 題不管提示詞寫得多好都答不出來,因為答案既不在窗口裡,也不在訓練資料裡。第二層改得了「怎麼問」,改不了「它知道什麼」。
所以第三層「外部知識」換一個問題問:每一次呼叫之前,窗口裡該放進哪些東西。 Anthropic 把這件事叫做脈絡工程(context engineering):在推論時挑選並維護窗口裡最合適的那組詞元,範圍不只提示詞,還包括外部資料、對話歷史與工具。
其中最常見的做法,是回答之前先把知識庫裡相關的內容取出來、接進提示詞,也就是檢索增強生成(retrieval-augmented generation,RAG)。Claude 的官方文件把 RAG 列為搜尋結果內容區塊的主要用途:你把查到的內容交給它,它回答時直接標出引用了你的哪一份文件。
這一篇埋好的兩件事會一路用到:窗口是邊際效益遞減的有限資源,還有每加一種外部資料,評估集都要重跑。
它就是不知道你的事:把檔案給它看。
第三層的第一步先不談檢索,用最直接的方法:把檔案整份交給它。 第 3、4 題它都老實說了不知道,因為那份團隊筆記從來沒有進過它的窗口。下一篇把筆記交出去,再重跑這兩題,看「不知道」會變成答對,還是變成另一種更難發現的錯。
usage 欄位。

快取失效照 tools → system → messages 層級走這點,實務上有個常見踩法:把「今天的日期」或 session 狀態塞進 system prompt,每一輪前綴都在變,快取永遠不命中,還以為快取沒開。時間戳這種每輪必變的東西要放在 messages 最尾端。另外改完提示詞我會先送 count_tokens 確認還在 512 門檻之上——刪太多字跌破門檻,快取是悄悄不生效的,要從 usage 才看得出來。

謝謝你補這個實務例子,這確實是我文章裡只寫了原則、沒寫出來的那一格。我可能會把這個點收進第 10 篇,那一篇會講一個請求裡該放什麼、依什麼順序排,剛好用得上,到時候會標明是你提供的。
謝謝你讀這個系列,也謝謝你留言。
期待第 10 篇。請求裡放什麼、依什麼順序排,跟快取前綴其實是一體兩面:會變的東西放 messages 尾端,前綴才穩,後面的內容怎麼改都不會讓快取失效。等你寫出來再交流。

 iThome鐵人賽
 看影片追技術